El contexto
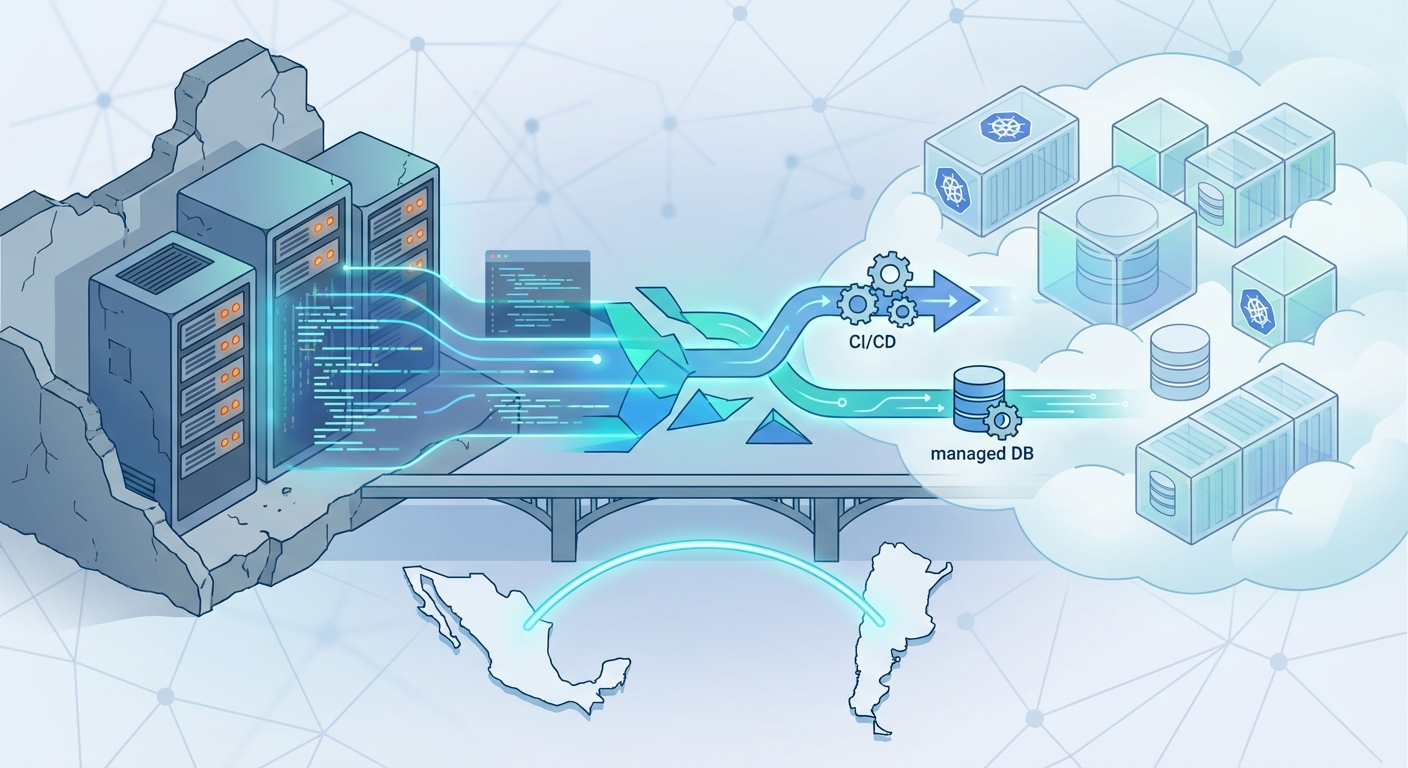
Cuando me invitaron a participar en el proyecto de Asegurus, la situación era la típica que encuentras en empresas que crecieron rápido: infraestructura legacy que funcionaba, pero que ya no escalaba. Clusters viejos, deployments manuales, bases de datos sin gestión centralizada, y un equipo distribuido entre México y Argentina que necesitaba colaborar de forma más eficiente.
Este post es un resumen de cómo abordamos la migración, qué decisiones tomamos, y las lecciones que nos dejó el proceso.
El estado inicial
La infraestructura existente tenía varios problemas que son comunes en setups legacy:
- Clusters desactualizados — Versiones viejas de orquestadores sin soporte, con configuraciones que nadie quería tocar por miedo a romper algo
- Deployments manuales — El proceso de poner código en producción involucraba SSHs, scripts caseros, y una cantidad preocupante de pasos que dependían de conocimiento tribal
- Bases de datos self-hosted — MySQL y PostgreSQL corriendo en VMs sin backups automatizados decentes, sin failover, sin monitoreo real
- Cero CI/CD — O mejor dicho, había un Jenkins medio abandonado que nadie confiaba en tocar
- Equipos aislados — Los devs en México hacían su parte, los de Argentina la suya, y la integración era un dolor de cabeza constante
Funcionaba, pero con alfileres. Y cada vez que había que escalar algo o hacer un cambio importante, era una operación de alto riesgo.
La estrategia de migración
No íbamos a hacer un big bang. Eso nunca funciona. La estrategia fue migración incremental con rollback en cada paso.
Fase 1: Kubernetes moderno
El primer paso fue montar clusters de Kubernetes actualizados y bien configurados. Esto significó:
- Clusters managed — Dejamos de mantener nuestros propios masters. Usamos servicios managed de Kubernetes para que el cloud provider se encargue del control plane
- Namespaces por equipo y ambiente — Desarrollo, staging, y producción claramente separados, con RBAC para que cada equipo tuviera acceso solo a lo que necesitaba
- Helm charts estandarizados — Cada servicio tiene su chart con valores por ambiente. Nada de yamls sueltos ni configuraciones ad-hoc
- Ingress unificado — Un solo punto de entrada con TLS automático, rate limiting, y routing basado en headers
La migración fue servicio por servicio. Levantábamos el servicio en el cluster nuevo, lo poníamos a correr en paralelo con el legacy, validábamos que todo funcionara igual, y luego switcheábamos el tráfico. Si algo fallaba, rollback inmediato.
Fase 2: Bases de datos managed
Este fue probablemente el paso más delicado. Migrar bases de datos en producción sin downtime es de las cosas más estresantes que puedes hacer en infraestructura.
- RDS/Cloud SQL — Movimos todas las bases a servicios managed con réplicas de lectura, backups automáticos cada hora, y failover automático
- Migración con réplicas — Configuramos replicación desde las bases legacy a las nuevas, dejamos que se sincronizaran, y luego hicimos el cutover durante ventanas de bajo tráfico
- Connection pooling — Implementamos PgBouncer para PostgreSQL y ProxySQL para MySQL, reduciendo la carga de conexiones y mejorando la latencia
- Monitoreo desde día uno — Alertas en Grafana para replication lag, query times, conexiones activas, y espacio en disco
Hubo noches largas. Pero al final, ninguna migración de base de datos tuvo más de 30 segundos de downtime, y la mayoría fueron zero-downtime.
Fase 3: CI/CD automatizado
Con la infraestructura nueva en su lugar, había que automatizar todo el flujo de deployment:
- GitHub Actions como motor principal de CI/CD
- Pipeline estándar: lint → test → build → push image → deploy a staging → smoke tests → deploy a producción
- GitOps con ArgoCD — El estado deseado de cada ambiente vive en Git. ArgoCD se encarga de sincronizar el cluster con lo que está en el repo
- Canary deployments — Para servicios críticos, no hacemos deploy del 100% de una vez. Empezamos con 10% del tráfico, monitoreamos métricas, y si todo está bien, escalamos gradualmente
- Rollback automático — Si las métricas de error rate suben por encima del umbral durante un canary, ArgoCD revierte automáticamente
El resultado: de deployments que tomaban horas y requerían a alguien de guardia, pasamos a deployments automáticos que toman menos de 15 minutos de push a producción.
Fase 4: Colaboración distribuida
Con equipos en México y Argentina, necesitábamos que la colaboración fuera fluida:
- Ambientes de preview por PR — Cada pull request levanta su propio ambiente efímero para que cualquiera pueda probar los cambios sin esperar a staging
- Documentación como código — ADRs (Architecture Decision Records) en el repo, no en wikis que nadie actualiza
- On-call rotativo — Calendario compartido de guardia con playbooks documentados para cada tipo de incidente
- Observabilidad unificada — Un solo Grafana, un solo stack de logs, métricas y trazas que todos los equipos pueden consultar
Las lecciones
Después de meses de migración, hay varias cosas que me llevo:
Lo que funcionó
- Migración incremental — Siempre. Nunca big bang. El costo de ir más lento es infinitamente menor que el de romper todo
- Invertir en observabilidad primero — Antes de migrar cualquier servicio, asegúrate de que puedes ver qué está pasando. Si no puedes medir, no puedes migrar con confianza
- Ambientes efímeros — Game changer para equipos distribuidos. Elimina el cuello de botella de "staging está ocupado"
- Documentar decisiones, no solo código — Los ADRs fueron clave para que nuevos miembros del equipo entendieran el por qué de cada decisión arquitectónica
Lo que haría diferente
- Empezar con CI/CD antes que con la infraestructura — En retrospectiva, haber automatizado los deployments primero habría hecho la migración de infra más suave
- Más testing de carga temprano — Hicimos load testing, pero debimos empezar antes. Algunos cuellos de botella los descubrimos tarde
- Comunicación más estructurada — Con dos países y múltiples zonas horarias, las decisiones asíncronas necesitan más proceso del que teníamos al inicio
Los números
Porque al final, lo que importa son los resultados:
- Tiempo de deploy: de ~2 horas (manual) a ~12 minutos (automatizado)
- Downtime mensual: de ~4 horas a menos de 5 minutos
- Tiempo de recovery: de horas a minutos (rollback automático)
- Costo de infra: reducción del 35% al consolidar y usar recursos managed
- Developer experience: encuestas internas pasaron de 4.2/10 a 8.1/10
Cierre
Migrar infraestructura legacy nunca es sexy. No es el tipo de proyecto que genera aplausos inmediatos porque la mayoría del trabajo es invisible para el usuario final. Pero es el tipo de trabajo que determina si tu equipo puede moverse rápido o si cada cambio es una apuesta.
El stack de Asegurus hoy es moderno, automatizado, observable, y manejable por un equipo distribuido. No es perfecto, nada lo es, pero la diferencia entre donde estábamos y donde estamos ahora es de otro nivel.
Si estás considerando una migración similar, mi consejo es simple: empieza chico, mide todo, y no intentes ser héroe. La infraestructura se migra un servicio a la vez.