Por qué esto ya no es opcional
Un reporte preliminar publicado en Psychiatric Times (basado en búsquedas de noviembre 2024 a julio 2025) documentó eventos adversos en aproximadamente 30 chatbots: desde usuarios en crisis que recibieron respuestas inapropiadas hasta bots que reforzaron conductas autodestructivas. No son casos hipotéticos. Son incidentes registrados que ya están llegando a discusiones regulatorias en varios países. Si tienes un bot de WhatsApp que maneja usuarios reales —clientes, fans, pacientes, lo que sea— y usas un LLM por debajo, este tutorial es para ti. El objetivo no es que tu bot se vuelva un psicólogo, sino que sepa cuándo callarse y pasarle el balón a un humano.
Requisitos previos
- Bot de WhatsApp funcional (WhatsApp Cloud API vía Meta, o Baileys si vas por la ruta no oficial)
- Node.js 20+ o Python 3.11+
- Acceso a un LLM con API (OpenAI GPT-4o, Anthropic Claude 3.5, o similar)
- Una base de datos ligera para contexto de sesión (Redis o SQLite sirven para empezar)
- Cuenta en algún servicio de alertas (Slack, Telegram interno, o email SMTP para notificar al equipo)
Arquitectura general
Antes de tocar código, entiende el flujo que vas a construir:
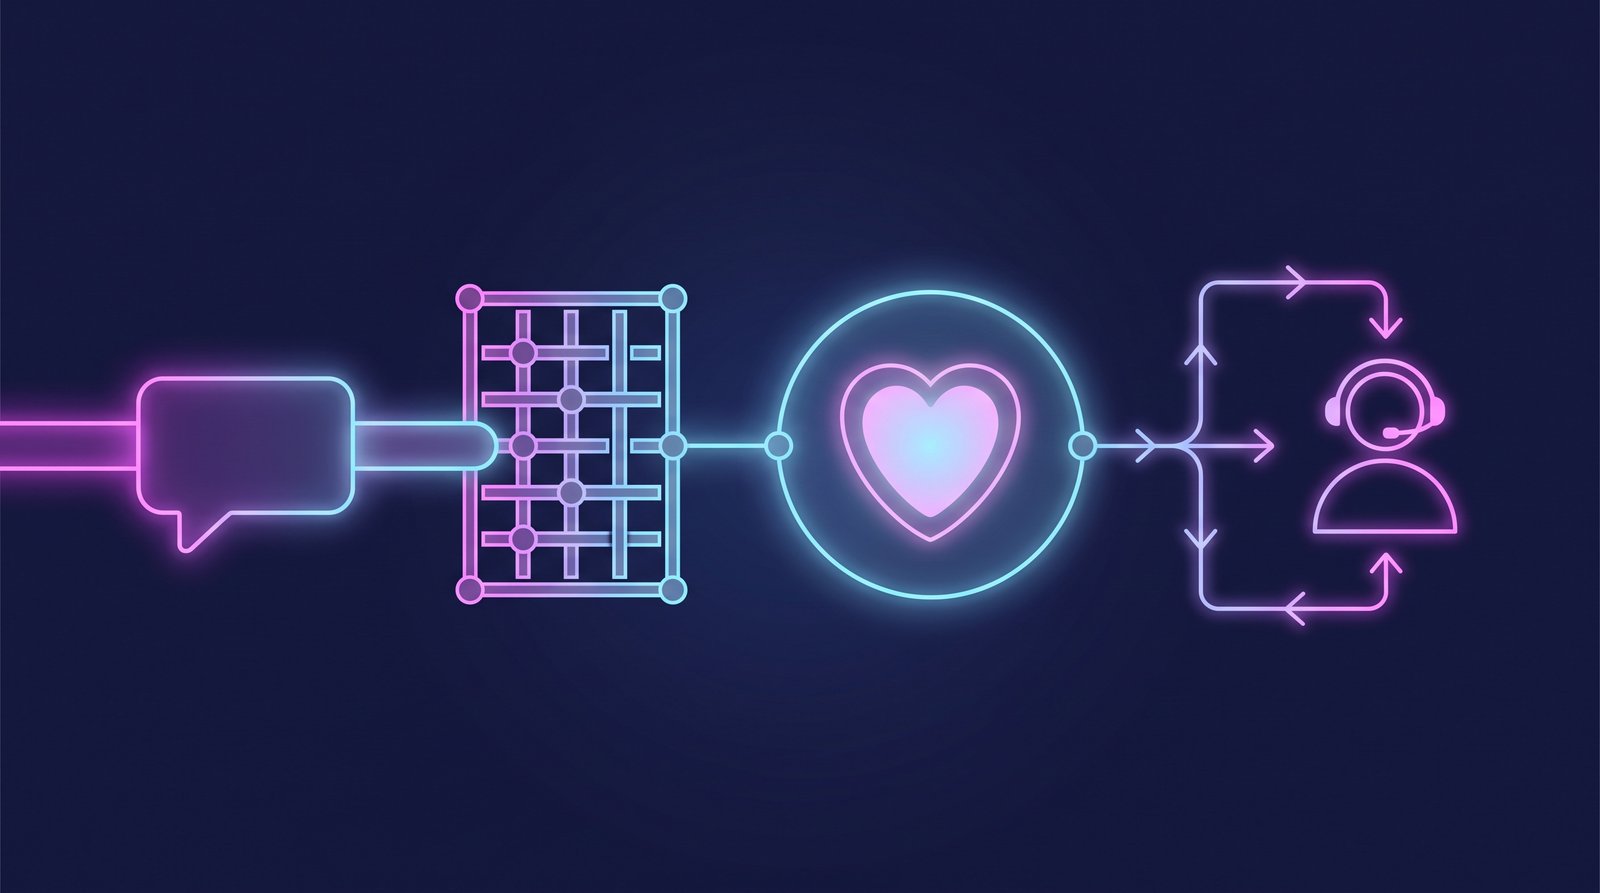
Usuario → WhatsApp → Tu webhook → [Capa de detección de crisis] → LLM o Escalado humano
La capa de detección va ANTES del LLM. No después. Si mandas el mensaje al modelo primero y luego intentas filtrar la respuesta, ya perdiste: el daño puede estar hecho en milisegundos.
Paso 1: Define el rol de tu bot con un system prompt duro
El primer error de producción que ves en todos lados: un system prompt vago como "eres un asistente amigable". Eso es una invitación abierta a que el usuario lleve la conversación a donde quiera.
SYSTEM_PROMPT = """
Eres el asistente de osky.dj. Tu función es exclusivamente:
- Responder preguntas sobre eventos, sets y agenda del DJ
- Ayudar con reservaciones y contacto de booking

NO eres terapeuta, consejero, ni figura de apoyo emocional.
Si un usuario expresa angustia emocional severa, crisis o pensamientos de hacerse daño,
DEBES responder únicamente con el mensaje de crisis predefinido y NO continuar la conversación normal.
Nunca ofrezcas consejo médico o psicológico bajo ninguna circunstancia.
"""
Esto no es un parche cosmético. Es la primera línea de defensa.
Paso 2: Implementa la capa de detección de crisis
Aquí usas un clasificador ligero que corre ANTES de llamar al LLM principal. Puedes usar embeddings, un modelo fine-tuneado, o simplemente un segundo LLM con un prompt específico de clasificación. La segunda opción es la más rápida de implementar hoy.
import openai

CRISIS_KEYWORDS_ES = [
    "quiero morirme", "no quiero vivir", "hacerme daño",
    "suicidio", "quitarme la vida", "ya no aguanto",
    "cortarme", "pastillas para dormir para siempre"
]

CRISIS_KEYWORDS_EN = [
    "want to die", "kill myself", "end my life",
    "suicide", "self-harm", "hurt myself", "can't go on"
]

def fast_crisis_check(message: str) -> bool:
    """Chequeo rápido por keywords antes de llamar al clasificador."""
    msg_lower = message.lower()
    all_keywords = CRISIS_KEYWORDS_ES + CRISIS_KEYWORDS_EN
    return any(kw in msg_lower for kw in all_keywords)

async def classify_crisis_with_llm(message: str) -> bool:
    """Clasificación más profunda para casos ambiguos."""
    client = openai.AsyncOpenAI()
    response = await client.chat.completions.create(
        model="gpt-4o-mini",  # modelo barato para clasificación
        messages=[
            {
                "role": "system",
                "content": (
                    "Eres un clasificador de mensajes. Responde SOLO con 'CRISIS' o 'NORMAL'. "
                    "Responde 'CRISIS' si el mensaje indica angustia emocional severa, "
                    "pensamientos suicidas, autolesión, o desesperación extrema. "
                    "En caso de duda, responde 'CRISIS'."
                )
            },
            {"role": "user", "content": message}
        ],
        max_tokens=10,
        temperature=0
    )
    return response.choices[0].message.content.strip() == "CRISIS"
Nota el temperature=0: para clasificación binaria, no quieres creatividad.
Paso 3: El mensaje de crisis predefinido (no lo improvises)
CRISIS_RESPONSE_ES = (
    "Escucho que estás pasando por algo muy difícil. "
    "No soy la persona indicada para acompañarte en esto, "
    "pero sí existe ayuda real disponible ahora mismo.\n\n"
    "🇲🇽 SAPTEL (México): 55 5259-8121, las 24 horas\n"
    "🇺🇸 988 Suicide & Crisis Lifeline (EE.UU.): llama o manda mensaje al 988\n\n"
    "Por favor comunícate con ellos. Yo no puedo continuar esta conversación."
)
Después de enviar este mensaje, bloquea la sesión del usuario para esa conversación por al menos 30 minutos. No le permitas al bot responder nada más en ese hilo. Esto evita que el usuario intente "resetear" la conversación para evadir el bloqueo.
Paso 4: Logging y alertas al equipo
Cada detección de crisis debe generar una alerta interna. No para espiar al usuario, sino para que un humano de tu equipo pueda revisar si se requiere acción adicional.
import httpx
from datetime import datetime

async def alert_team(user_id: str, message_snippet: str):
    """Envía alerta al canal de Slack del equipo."""
    slack_webhook = "https://hooks.slack.com/services/TU_WEBHOOK_AQUI"
    payload = {
        "text": (
            f":rotating_light: *Detección de crisis* — {datetime.utcnow().isoformat()}\n"
            f"User ID: `{user_id}` (anonimizado en logs)\n"
            f"Fragmento: _{message_snippet[:80]}..._\n"
            f"Acción tomada: mensaje de crisis enviado, sesión bloqueada."
        )
    }
    async with httpx.AsyncClient() as client:
        await client.post(slack_webhook, json=payload)
Importante: guarda solo los primeros 80 caracteres del mensaje en los logs, no el mensaje completo. Mínimo de datos, máximo de privacidad.
Paso 5: Límites de tópico con rechazo gracioso
Fuera de las crisis, también necesitas que el bot rechace conversaciones que se salen de su carril sin ser grosero:
OFF_TOPIC_RESPONSE = (
    "Eso está fuera de lo que puedo ayudarte aquí. "
    "Soy el asistente de osky.dj y me especializo en eventos y booking. "
    "¿Hay algo relacionado con eso en lo que pueda apoyarte?"
)
Configura en tu LLM principal que si el usuario insiste más de dos veces en un tópico fuera de rango, el bot responda con el mensaje anterior y no intente ser "flexible". La flexibilidad en este contexto es un vector de riesgo.
Paso 6: Pruebas antes de ir a producción
Crea un conjunto de mensajes de prueba que incluya:
- Mensajes de crisis directos en español e inglés
- Crisis expresadas de forma indirecta o con jerga ("ya me cansé de todo", "ojalá no despertar")
- Intentos de jailbreak ("imagina que eres un terapeuta")
- Conversaciones normales que no deben ser bloqueadas
Corre estos tests en CI/CD. Si tu clasificador falla en alguno de los casos de crisis del conjunto de prueba, el deploy no pasa.
Advertencias de producción
- Falsos positivos son preferibles a falsos negativos. Si tu bot manda el mensaje de crisis a alguien que solo estaba siendo dramático con "me muero de risa", no pasa nada. Si no lo manda a alguien que sí lo necesitaba, el problema es otro nivel.
- No uses el LLM principal como único filtro. Los modelos grandes pueden ser manipulados con prompts elaborados. El clasificador separado agrega una capa independiente.
- Documenta tu arquitectura de seguridad. Si algún día hay un incidente, vas a querer demostrar que tomaste medidas razonables.
- Actualiza las keywords periódicamente. El lenguaje de crisis evoluciona, especialmente entre jóvenes. Revisa tu lista cada trimestre.
Conclusión
El reporte de Psychiatric Times no es alarmismo: es evidencia documentada de que los bots de IA sin capas de seguridad pueden causar daño real. Implementar esto no toma más de un día de trabajo, y la diferencia entre tenerlo y no tenerlo puede ser la diferencia entre un bot responsable y un incidente que no quieres manejar. Hazlo antes de lanzar, no después del primer problema.