Anthropic lanzó el 29 de octubre, en beta, la Usage and Cost Analytics API de Claude Platform: dos endpoints nuevos, /v1/organizations/analytics/usage y /v1/organizations/analytics/cost, que reportan tokens y costo de una organización y permiten agruparlos por modelo, workspace, API key o por el usuario o la cuenta de servicio que hizo cada petición. En la misma nota pasó a legacy la Usage and Cost API que conocíamos y cuatro endpoints de reportes de la Claude Enterprise Analytics API. Siguen soportados y no hay fecha de retiro anunciada, pero el mensaje es claro: si tienes un script, un dashboard o una alerta que lee el gasto de Claude, ya tienes tarea de migración pendiente, y conviene entender bien qué cambia antes de hacerla, porque no todo es mejora.
Qué anunció Anthropic
Según las notas de versión de Claude Platform:
- La API nueva está en beta y exige el header
anthropic-beta: analytics-usage-cost-2026-08-24, además delanthropic-versionde siempre. - Sirve igual para organizaciones de Claude Console (la plataforma de API) y de Claude Enterprise. Es la primera vez que ambas usan la misma integración para estos datos.
- Pasan a legacy la Usage and Cost API (
/v1/organizations/usage_report/messagesy/v1/organizations/cost_report) y los endpointsusage_report,cost_report,user_usage_reportyuser_cost_reportde la Enterprise Analytics API. - Todos los legacy "remain supported", y Anthropic publicó guías de migración para los dos casos.
Los SDK y la CLI ant mandan los headers solos y paginan por ti, así que en Python la llamada se ve como client.beta.organization.analytics.usage.list(...).
Cómo responde la API nueva
El cambio de fondo está en la forma de los datos. La API vieja devolvía una lista de cubetas de tiempo, de la más antigua a la más nueva, incluso vacías, y dentro de cada una una lista de resultados. La nueva devuelve filas: cada fila es una combinación de las dimensiones que pediste, con su starting_at y ending_at, un objeto group con las dimensiones y otro usage o cost con las métricas.
- Ranking por defecto. Las filas vienen ordenadas por la métrica que elijas (
total_tokenspor defecto en uso,amounten costo), de mayor a menor. Responder "¿qué API key gastó más este mes?" es una sola llamada. - Hasta cinco dimensiones en
group_by[], y filtros por casi cualquiera de ellas (models[],workspace_ids[],api_key_ids[]…) con hasta 100 valores cada uno. Los filtros del mismo tipo se combinan con OR y los distintos con AND. - Cubetas opcionales. Con
time_bucket_widthen1m,1ho1dpartes cada combinación por tiempo en UTC. Sin él, recibes el total del rango. - Costo con más detalle. Cada fila trae
amount(con descuentos, antes de créditos) ylist_amount(a precio de lista), en dólares. Ojo: los montos vienen como texto en centavos con seis decimales;"41280.000000"son 412.80 dólares. En el endpoint de costo puedes partir además porcost_typeytoken_typesin gastar el límite de cinco dimensiones. - Más cosas medidas. La ejecución de código aparece como filas de uso con
model: null, y ahora ambos endpoints reportan número de peticiones.
La dimensión que más importa: quién gastó
La API introduce la dimensión actor: el usuario, la cuenta de servicio, la identidad federada de AWS o Google Cloud o, si no hay nadie detrás, la propia API key a la que se atribuye una petición. Las keys personales y de cuenta de servicio aparecen como su dueño; las keys de workspace legacy, que no están ligadas a nadie, aparecen como actor y como key a la vez. El uso de Claude Code después de iniciar sesión sin API key se atribuye al miembro que entró, con api_key_id: null.
Para costo por usuario de Claude Code, la documentación propone products[]=claude_code&group_by[]=actor. Para equipos que reparten cuentas entre varios desarrolladores o varios clientes, eso es justo la pieza que faltaba para cobrar o poner límites con datos y no con corazonadas.
Lo que se pierde o cambia al migrar
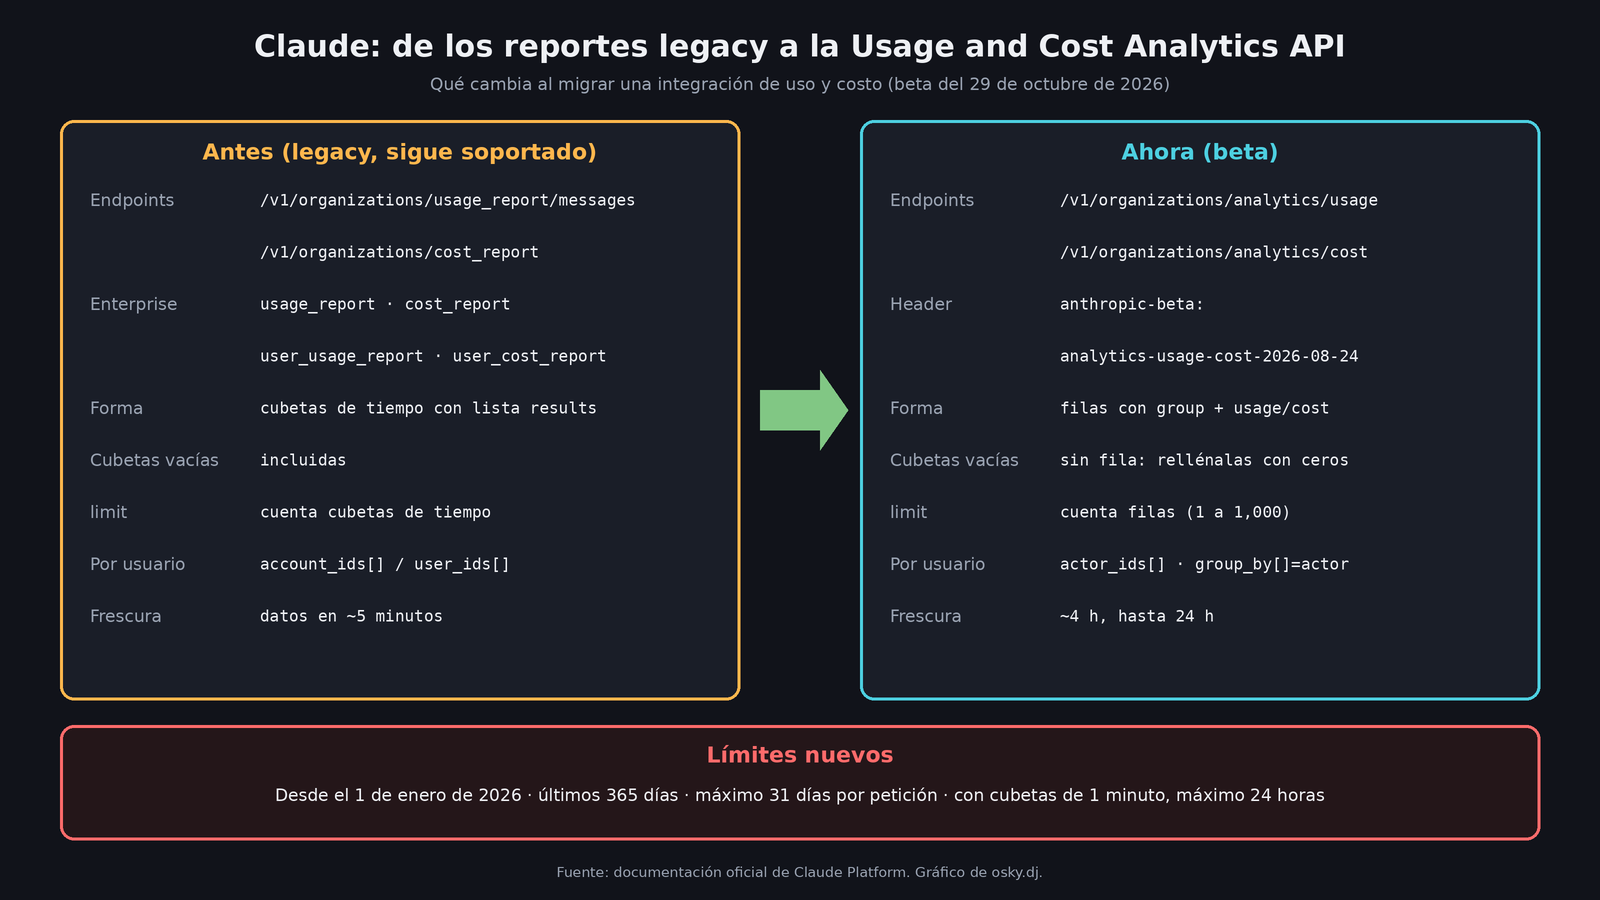
Aquí está la letra chiquita, sacada de la tabla de migración oficial:
| Tema | Legacy | Analytics API (beta) |
|---|---|---|
| Frescura | Datos en unos 5 minutos | Normalmente 4 horas, hasta 24 |
| Cubetas vacías | Incluidas | No hay fila; hay que rellenar con ceros |
limit |
Cuenta cubetas | Cuenta filas, de 1 a 1,000 (20 por defecto) |
| Rango | Cualquiera | Desde el 1 de enero de 2026, últimos 365 días, máximo 31 días por petición |
| ID desconocido | Error | No coincide con nada, sin error |
| Workspace por defecto | workspace_id: null |
Su ID real wrkspc_… |
| Por usuario | account_ids[], service_account_ids[] |
actor_ids[] y group_by[]=actor |
Tres puntos merecen atención. El primero es la frescura: si hoy tienes una alerta que te avisa cuando un script se desboca, con la API nueva te vas a enterar horas después. El segundo: un nombre de modelo mal escrito en models[] ya no truena, simplemente devuelve vacío, así que un dashboard puede marcar cero sin que nadie note el error. El tercero: los valores se pueden revisar hasta unos 7 días después de cerrar el mes, y Anthropic recomienda consultar solo meses que terminaron hace al menos una semana si quieres totales finales.
Para Enterprise la migración trae ganancias claras: los reportes viejos solo devolvían los 100 grupos principales por cubeta y la API nueva devuelve todas las combinaciones, además de permitir agrupar por actor junto con otras dimensiones.
Cómo migrar sin romper nada
Esto sale de la documentación oficial de Claude Platform; no lo probé para este artículo.
- Agrega el header beta y cambia la ruta a
/analytics/usageo/analytics/cost. Tu Admin API key sirve igual. - Renombra
bucket_widthatime_bucket_widthy pásalo explícito (1dpara conservar tus filas diarias): ya no tiene valor por defecto. - Si tu reporte necesita días seguidos, usa
order_by=time&order=asc, pagina conlimit=1000, agrupa porstarting_aty rellena con ceros los días sin uso. - Parte en varias peticiones cualquier rango de más de 31 días.
- Cambia los filtros de usuario a
actor_ids[]y revisa el caso del workspace por defecto, que ahora trae ID. - Convierte los montos de centavos a dólares antes de mostrarlos.
Mi lectura
Es una mejora real para quien necesita atribuir gasto: ranking, actores y una sola integración para Console y Enterprise ahorran código feo. Pero no la vendería como reemplazo directo. Por la frescura de horas, la API nueva sirve para finanzas, cierres de mes y dashboards; para alertas de gasto casi en tiempo real, el endpoint legacy sigue siendo la mejor opción mientras exista. Mi recomendación sería migrar los reportes ahora, que no hay prisa, y dejar las alertas en el legacy hasta que Anthropic diga algo sobre su retiro. "Legacy" sin fecha no es un apagón, pero sí es un aviso.