Google presentó el 12 de noviembre de 2026 Gemini 4 Hydrogen, el tercer modelo de la familia Gemini 4 después de Carbon y Argon. No es el más inteligente de la casa ni pretende serlo: Google lo vende como el modelo "de diario" para programar y para agentes, rápido y barato, y de paso lo metió como motor del buscador para todos los usuarios. Para quien construye con la API, la noticia práctica es otra: Hydrogen es el reemplazo recomendado de Gemini 3.8 Flash, y la migración trae cambios que pueden romper código que hoy funciona.
Qué es Hydrogen y dónde encaja
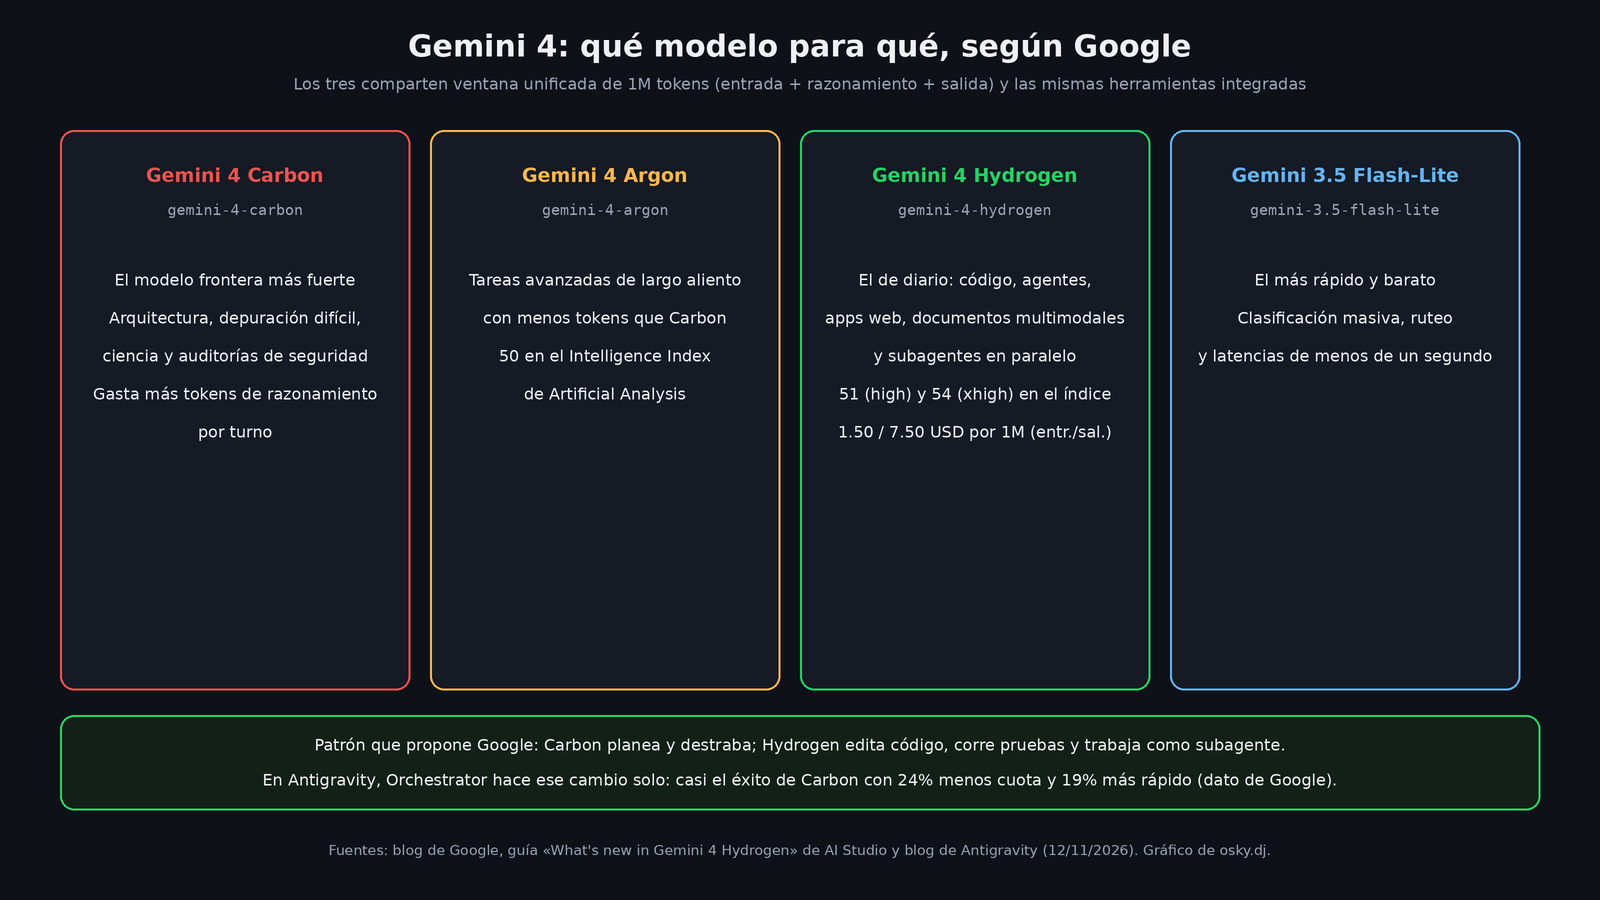
Según el anuncio de Koray Kavukcuoglu, vicepresidente sénior de Google DeepMind y arquitecto jefe de IA de Google, Carbon y Argon quedan para el razonamiento profundo y de largo aliento, mientras que Hydrogen está hecho para "ejecución rápida" en flujos de agentes: escribir código, correr pruebas, verificar cambios. La guía para desarrolladores de AI Studio lo deja todavía más claro al repartir papeles:
- Carbon (
gemini-4-carbon): el modelo frontera más fuerte, para arquitectura, depuración difícil, ciencia y auditorías de seguridad. - Argon (
gemini-4-argon): tareas avanzadas de largo aliento con menos tokens que Carbon. - Hydrogen (
gemini-4-hydrogen): código cotidiano, apps web, agentes con herramientas, documentos multimodales y subagentes en paralelo. Es el upgrade recomendado desde 3.8 Flash y los modelos Gemini 3 y 2.5 anteriores. - Gemini 3.5 Flash-Lite sigue siendo el más rápido y barato, para clasificación masiva y ruteo.
Los números que presume Google: en el Intelligence Index de Artificial Analysis, Hydrogen saca 51 en su nivel de razonamiento por defecto, uno más que Argon (50), y llega a 54 en el nivel más alto. Contra 3.8 Flash dice que termina tareas 2.5 veces más rápido, que en Terminal-Bench 4.1 pasa de 18.2% a 57% y que reduce más de cinco veces las afirmaciones inventadas. Todo eso son cifras del fabricante; las mediciones independientes van a tardar unos días en llegar.
Precio y especificaciones
La tabla oficial pone el precio de pago en 1.50 USD por millón de tokens de entrada y 7.50 USD por millón de salida, plano en toda la ventana de contexto. Esa ventana es de 1,048,576 tokens, unificada: entrada, razonamiento y salida salen de la misma bolsa. Una sola petición entrega hasta 65,536 tokens; para respuestas más largas hay que usar ejecución en segundo plano (background: true), que sigue generando en tramos de 64K hasta llenar la ventana.
Hydrogen tiene cuatro niveles de razonamiento: low, medium, high (el de fábrica) y xhigh, que es nuevo. Google recomienda empezar en high, guardar xhigh para problemas difíciles de varios pasos porque gasta más tokens y "puede pensar de más" en preguntas simples, y quedarse con el nivel más bajo que pase tus pruebas. El modelo está en los niveles gratuito y de pago de AI Studio y de la API.
Migrar desde 3.8 Flash: lo que se rompe
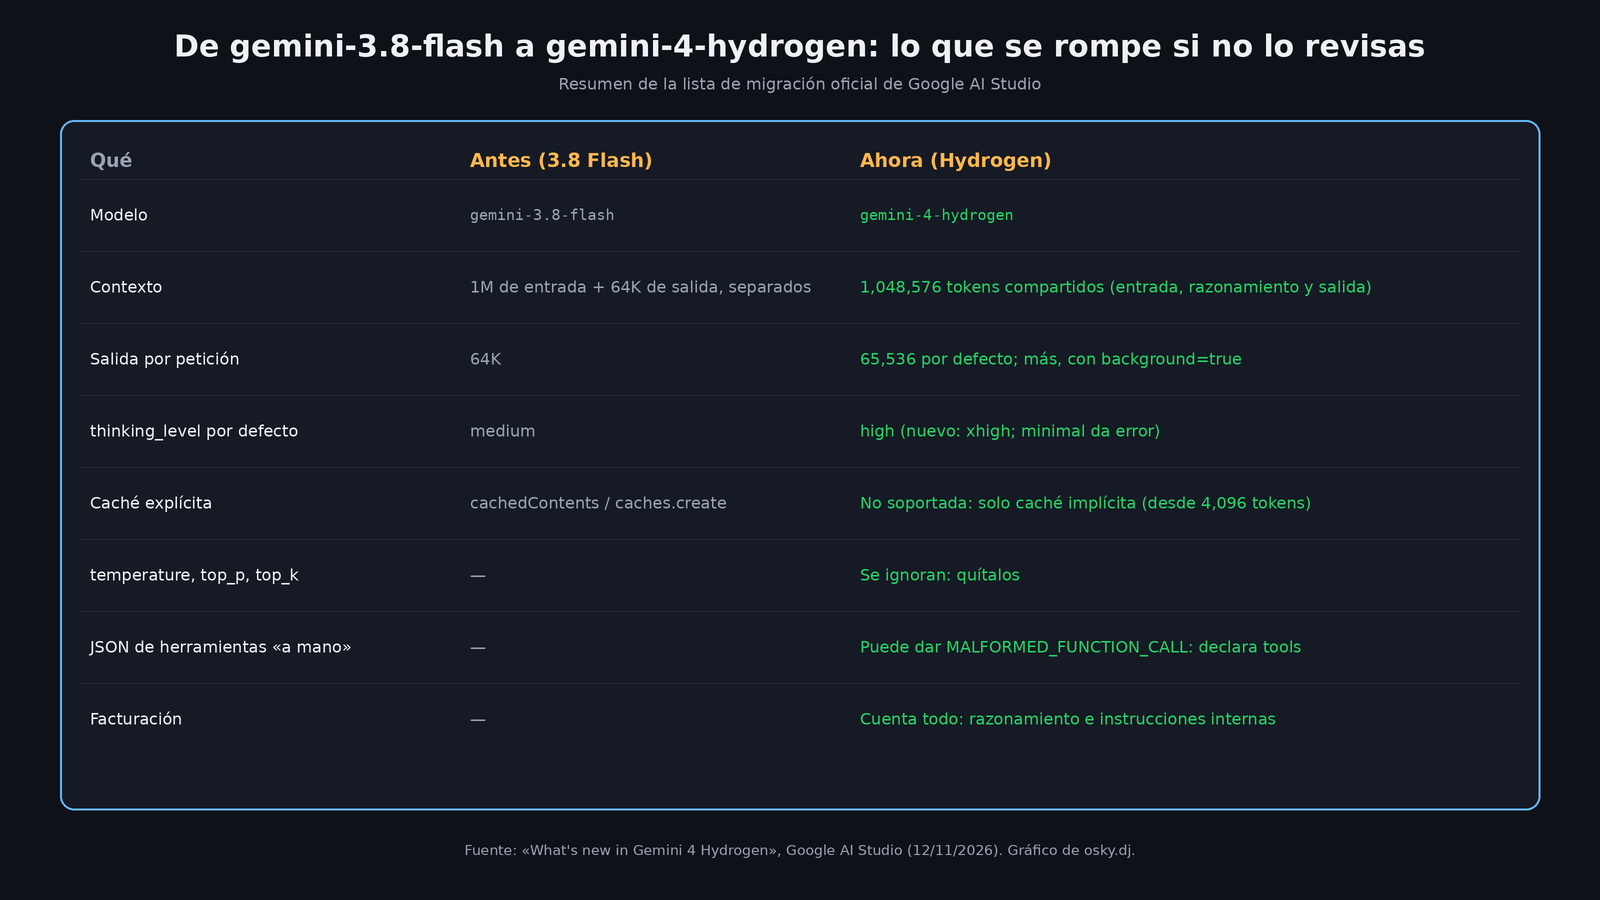
Esta es la parte que hay que leer antes de cambiar una línea en producción. La lista de migración de Google dice que no basta con cambiar gemini-3.8-flash por gemini-4-hydrogen:
- El contexto ya no está separado. 3.8 Flash tenía 1M de entrada y 64K de salida por aparte; Hydrogen comparte el millón entre todo. Google pide quitar los topes bajos de
max_output_tokensque traigas fijos (como 8,192) o subirlos a 65,536, porque ese tope ahora incluye el razonamiento. - El razonamiento por defecto sube de
mediumahigh, y el nivelminimalahora devuelve error. - Se acaba la caché explícita.
cachedContentsycaches.createno están soportados; queda la caché implícita, que se activa sola desde 4,096 tokens y descuenta 95% en los aciertos. temperature,top_pytop_kse ignoran. El servidor no los respeta aunque los mandes.- Herramientas declaradas, no improvisadas. Si le pides por instrucciones de sistema que escupa JSON de herramientas sin declarar ninguna, puede regresar
MALFORMED_FUNCTION_CALL. Hay que usar function calling nativo o salidas estructuradas. - Se cobra todo: tokens de razonamiento, instrucciones internas de grounding y declaraciones de funciones.
Si ya usas Carbon o Argon, pasarte a Hydrogen no requiere cambios en el esquema de las peticiones, según la misma guía. Además, el agente Antigravity de Gemini Managed Agents ya usa Hydrogen por defecto.
Orchestrator: dos modelos en una sola sesión
En Google Antigravity, su entorno de programación con agentes, Hydrogen llega junto con Orchestrator, una opción del selector de modelos que alterna entre Carbon y Hydrogen dentro de la misma tarea. Carbon explora y arma el plan, Hydrogen escribe, actualiza paquetes y corre pruebas, y si se atora le regresa el control a Carbon. Google dice que así logra casi el mismo éxito que Carbon solo, con 24% menos cuota y 19% más rápido. Un detalle: el blog principal atribuye esa cifra a Terminal-Bench 4.0 y el de Antigravity a la 4.1.
En Antigravity, Hydrogen está para suscriptores de pago de Google AI Pro y Ultra. Orchestrator llega con Carbon y Argon para Ultra, y solo con Argon para Pro.
Hydrogen en el buscador
Del lado del público, Robby Stein, vicepresidente de producto de Search, lo llamó "la mayor actualización de modelo" que ha tenido el buscador. Google dice que Hydrogen ya está disponible para todos los usuarios del mundo y que entiende mejor preguntas de varias partes o con faltas de ortografía, amplía la técnica de query fan-out (lanzar búsquedas simultáneas por subtemas) para mostrar más enlaces y responde con más imágenes, tablas comparativas y herramientas a la medida. Según Hipertextual, se elige con el botón "+" bajo la caja de búsqueda y puede tardar en aparecer.
En la app de Gemini sale en el selector de modelos; los usuarios gratuitos lo reciben a través de la selección automática, cuando el sistema decide que es el adecuado para la pregunta.
Seguridad, según la tarjeta del modelo
Google afirma que Hydrogen reduce hasta 81% las extralimitaciones en tareas de agente frente a 3.8 Flash, que es hasta dos veces menos propenso a saltarse límites de permisos cuando una tarea está bloqueada y que resiste 2.3 veces mejor la inyección indirecta de instrucciones en el benchmark Gray Swan IPI. Los detalles están en la tarjeta del modelo.
Mi lectura
Lo interesante aquí no es el 51 contra 50 en un índice; es el precio y el patrón de trabajo. Google está empujando abiertamente la idea de que nadie debería usar el modelo más caro para todo: un modelo grande que planea y uno barato que ejecuta. Para un bot o un agente que hoy corre sobre 3.8 Flash, Hydrogen promete más calidad, pero el cambio de costo depende del nivel de razonamiento que elijas: con high por defecto y el razonamiento facturado, la cuenta puede subir aunque el precio por token se vea razonable. Antes de migrar, conviene correr tus casos reales en medium y high, revisar los topes de salida y quitar la caché explícita. Y ojo con quien dependa del tráfico de Google: un buscador que responde con tablas y herramientas propias es, otra vez, un buscador que te manda menos visitas, aunque Google prometa "más enlaces".
Fuentes
- Introducing Gemini 4 Hydrogen (Google, anuncio oficial)
- What's new in Gemini 4 Hydrogen (Google AI Studio, guía para desarrolladores)
- Google Search gets a major upgrade with Gemini 4 Hydrogen (Google)
- Gemini 4 Hydrogen and Orchestrator (blog de Google Antigravity)
- Gemini 4 Hydrogen: everyday coding and agentic workflows for developers (Google)
- Tarjeta del modelo Gemini 4 Hydrogen (Google DeepMind, PDF)
- Google lanza Gemini 4 Hydrogen y lo integra con su buscador (Hipertextual)
- Discusión en Hacker News