Hoy, a las 11 de la mañana (hora de la Ciudad de México), nos quedamos sin correo. Tampoco tuvimos intranet: autentica con Entra ID, la plataforma de identidad de Microsoft, y solo tuvieron acceso quienes ya tenían una sesión iniciada.
No fuimos los únicos. Microsoft 365 tuvo una de sus caídas más grandes del año: Outlook, Exchange Online, Teams, SharePoint, Copilot y hasta Defender. Para media tarde, las redes ya habían encontrado al culpable: "es un ataque con IA". Me puse a revisar qué hay detrás de esa frase, porque en infraestructura la diferencia entre un rumor y un dato es justo lo que decide qué haces al día siguiente.
Lo que pasó, con las palabras de Microsoft
- 16:17 UTC (10:17 en CDMX). Microsoft abre el incidente EX1550543: usuarios que no pueden conectarse a sus buzones de Exchange Online "por varios métodos de conexión". Afecta Outlook web, la app de escritorio, el celular y la API REST. Es decir, todas las puertas al buzón.
- 17:54 UTC. Primer aviso público en X. Trece minutos después reconocen que puede afectar "a usuarios de cualquier región".
- 18:26 UTC. Abren MO1550821 para toda la suite: Teams, SharePoint, Copilot, Defender XDR, Intune, Purview, Planner.
- Outlook llega a cerca de 129 mil reportes en Downdetector alrededor de la una de la tarde, hora del este de Estados Unidos.
La primera explicación fue "carga elevada". Luego Microsoft se corrigió a sí misma, y esta es la frase clave: "la carga elevada no se debe a un aumento de tráfico, sino a que varios servidores quedaron inesperadamente fuera de servicio, lo que satura al resto de la infraestructura". Más tarde agregó que esos servidores estaban fallando los chequeos de salud automáticos, que el problema podía venir del componente que procesa esos chequeos, que un proceso que establece conexiones seguras se estaba saturando y que iban a revertir un cambio reciente de configuración de red que coincidió con el inicio.
Al momento de escribir esto, Microsoft reporta una recuperación parcial, servidor por servidor, y en su registro de incidentes la causa raíz sigue en "N/A".
¿Fue un ataque con IA?
No hay ninguna evidencia de eso. Microsoft no ha reportado actividad maliciosa, y todo lo que ha publicado describe una falla de disponibilidad: servidores que salen de servicio y los que quedan ahogándose. La teoría del "enjambre de agentes de IA" nació en foros, sin una sola fuente.
Tampoco es cierto que "también se cayeron Google, AWS y Cloudflare". Sus páginas de estado no reportaron incidentes. En Downdetector juntaron alrededor del 1% de los reportes de Outlook, y empezaron entre 38 minutos y una hora después. Es el efecto eco de siempre: cuando algo grande se cae, la gente reporta todo lo que tiene abierto.
¿Entonces por qué todos se lo creyeron? Porque el ambiente estaba listo. El 21 de octubre, investigadores apoyados en modelos de IA encontraron PHP2Shell, dos vulnerabilidades críticas en PHP que llevaban años escondidas. Gobiernos, bancos y aerolíneas apagaron sus sitios para parchar, CISA pidió actuar de inmediato y unos días después confirmó que ya se estaban explotando. Después de algo así, "fue la IA" suena creíble para cualquier cosa. Pero que algo suene creíble no lo vuelve cierto.
Cómo un health check tumba servidores sanos
Esta es la parte que más me interesa como alguien que opera infraestructura, porque explica cómo puede durar toda una tarde una caída sin hardware roto, sin ataque y sin pico de tráfico.
Un servicio del tamaño de Exchange Online no corre en un servidor. Corre en flotas enteras detrás de balanceadores, y el balanceador necesita saber a qué máquina mandarle cada petición. Para eso le pregunta a cada una, cada pocos segundos, si está sana. Si no contesta bien, deja de mandarle tráfico. En un día normal, esa regla es la razón por la que nunca te enteras de que se murió un servidor.
El problema empieza cuando el que se equivoca es el chequeo.
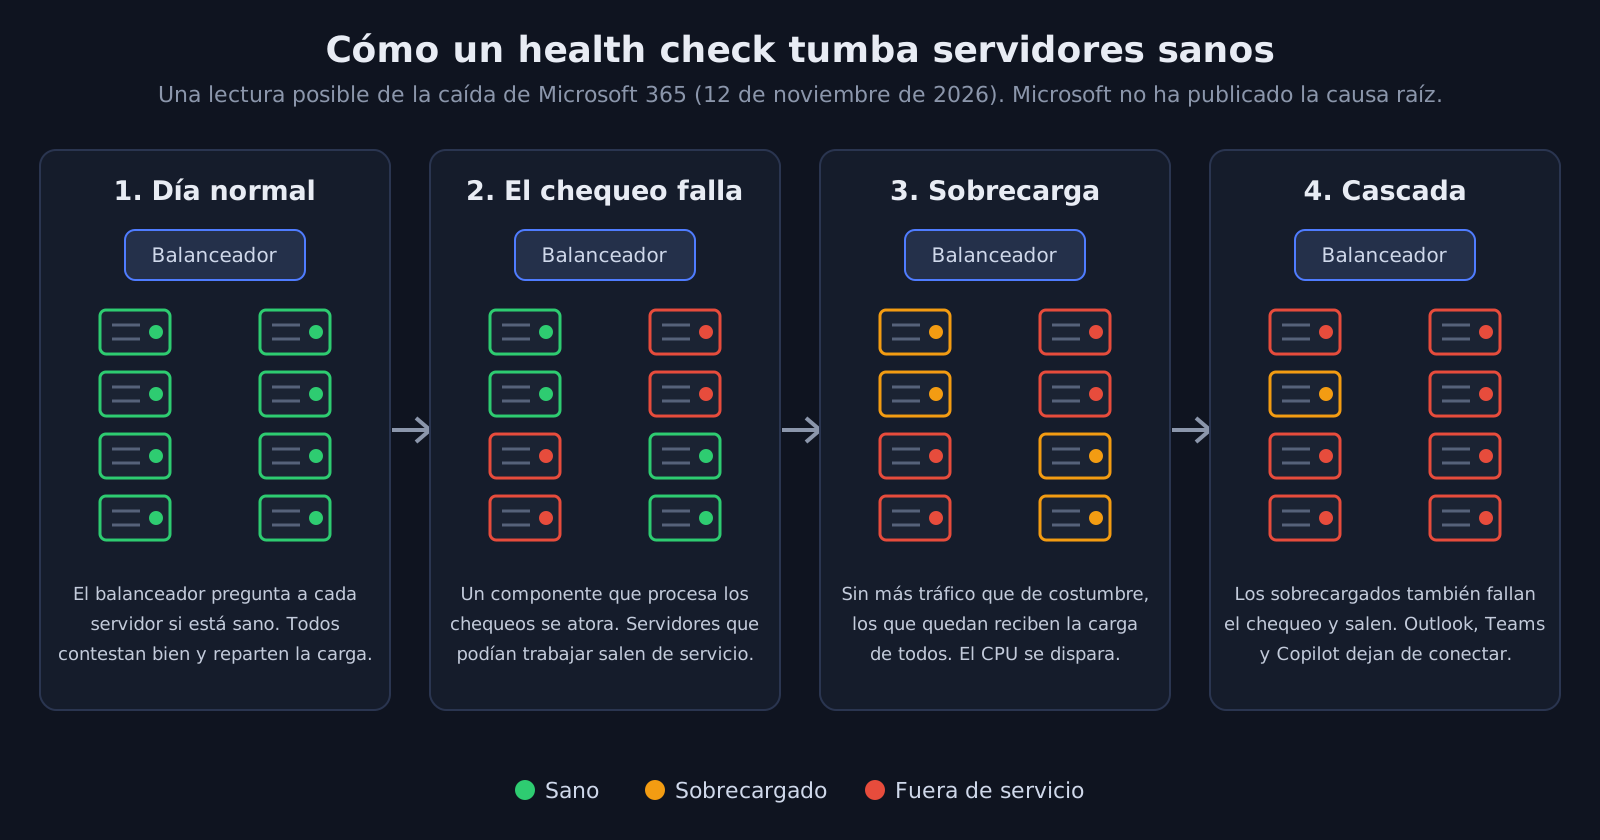
Si el componente que procesa los chequeos se atora, servidores que podían trabajar salen de servicio. Su carga se reparte entre los que quedan, que se sobrecargan, empiezan a responder lento, fallan su propio chequeo y también salen. Es una cascada que la automatización empuja sola. Amazon lo resume muy bien en su guía de health checks: si la automatización saca de servicio servidores que todavía podían hacer trabajo útil, hace más daño que bien.
Aclaro algo: esta es una lectura posible de lo que Microsoft ha publicado, no su causa raíz confirmada. El reporte posterior al incidente dirá si fue eso, el cambio de configuración de red o una combinación.
Lo que nos dejó a nosotros
Lo que más me llamó la atención fue la intranet: quien ya tenía sesión siguió trabajando y quien intentó entrar se quedó afuera. Es un recordatorio de que, cuando delegas la identidad en un proveedor, su caída también es tu caída, aunque tu servidor esté perfecto.
Lo que me llevo para mis propios sistemas:
- Un health check no debería poder apagar toda la flota. Pon un límite: si más de cierto porcentaje de los servidores "falla" al mismo tiempo, lo más probable es que el que esté mal sea el chequeo. En ese caso, mejor seguir mandando tráfico (fail open) que sacarlos a todos.
- La página de estado no puede depender de lo que se cayó. Microsoft tuvo que avisar por X. Si tu monitoreo y tus avisos viven en la misma infraestructura que vigilan, se apagan juntos.
- Ten un canal fuera de Microsoft 365 para coordinarte cuando se cae. Si todo tu equipo vive en Teams y Outlook, el día que se caen no hay ni por dónde decir "se cayó".
- El correo no se pierde. El incidente afectó el acceso a los buzones, no la entrega por SMTP. Y cuando un servidor rechaza un correo, el que lo manda lo reintenta durante horas o días. Antes de reenviar todo, espera a que se ponga al corriente.
- Después de cada caída llega el phishing. Esta semana van a circular correos de "tu buzón fue restaurado, vuelve a iniciar sesión". No hay que hacer nada del lado del usuario. Y nadie debería relajar el MFA ni el acceso condicional "mientras se arregla".
Lo que falta saber
Microsoft no ha dicho por qué empezaron a fallar los chequeos ni si este incidente tiene que ver con la falla de Exchange del 6 de noviembre, que también dejó buzones inaccesibles en Norteamérica. Cuando publique su reporte, actualizo este post. Mientras tanto, mi recomendación es la de siempre: antes de compartir el culpable, busca la fuente.
Fuentes
- BleepingComputer: Massive Microsoft 365 outage disrupts Outlook, Teams, Copilot worldwide
- SecurityWeek: Microsoft 365 Outage Disrupts Outlook, Exchange Online and Teams
- Al Jazeera y Reuters: Microsoft outage hits tens of thousands of users
- ThousandEyes: Microsoft 365 Outage Analysis, November 12, 2026
- Enrow: cronología, causa y qué pasó con los correos
- Microsoft 365 Status en X
- Foro Económico Mundial: el apagón por PHP2Shell
- Amazon Builders' Library: Implementing health checks